BOOKSEEK BOOK NOTES
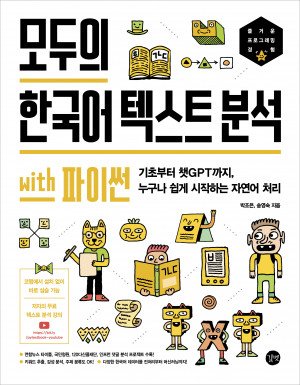
모두의 한국어 텍스트 분석 with 파이썬
파이썬 문자열과 자료 처리에서 단어 표현, 한국어 제목 분류 등의 텍스트 분석으로 이어지는 책입니다. 자연어 처리의 첫 실습을 한국어 자료와 연결하고 싶은 독자가 입력과 전처리부터 살펴볼 수 있습니다.
이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.
책의 기본 정보
- 출판사
- 길벗
- 출간일
- 2023-05-29
- 분량
- 316쪽
- ISBN
- 9791140704521
한국어 문장을 분석 자료로 다루는 출발점
모두의 한국어 텍스트 분석 with 파이썬은 코랩과 파이썬 문자열에서 시작해 한국어 자료를 분석하는 과정을 다룹니다. 2023년 5월 출간된 316쪽 인쇄본입니다. 자연어 처리라는 말은 들어 봤지만 문장을 코드 안에서 어떻게 다루는지 낯선 독자라면 첫 실습의 범위를 살펴볼 수 있습니다. 거대한 언어 모델을 직접 학습하는 내용부터 기대하는 책과는 출발점이 다릅니다.
텍스트 분석에서는 같은 문장도 어떤 단위로 나누고 어떤 표현을 남기는지에 따라 결과가 달라질 수 있습니다. 이 책을 읽으면서 입력한 문장과 처리한 뒤의 형태를 함께 확인해 보세요. 결과 점수만 보는 대신 자료가 어느 단계에서 바뀌는지 살펴보면 분석의 과정을 이해하기 쉽습니다. 짧은 문장 몇 개만으로도 이런 비교 연습을 시작할 수 있습니다.
이 책의 특징: 문자열에서 분류 작업으로 이어집니다
기초 부분에는 문자열의 표현과 인덱싱, 슬라이싱, 함수와 반복, 문자열 메서드를 다루는 내용이 있습니다. 판다스와 넘파이를 살펴본 뒤 단어 가방 모형과 TF-IDF로 범위를 넓힙니다. 문자를 다루는 코드가 자료의 표현으로 어떻게 연결되는지 알고 싶은 독자에게 의미 있는 순서입니다. 이미 파이썬을 안다면 필요한 부분부터 확인하며 읽을 수 있습니다.
한국어 제목의 주제 분류에서는 자료를 불러오고 분포와 길이를 확인하며 전처리하는 과정이 포함됩니다. 분류 모델의 이름을 고르는 일 전에 어떤 자료가 들어 있는지 살펴보는 단계가 있다는 점에 관심을 둘 수 있습니다. 동일한 주제의 문장만 많은지, 특정 표현이 결과에 영향을 주는지 질문하며 예제를 읽어 보세요. 학습 과정과 평가할 자료를 구분하는 습관도 필요합니다.
전처리 전후에 남은 의미를 확인해 보세요
문장에서 숫자나 기호, 자주 나오는 표현을 지운다면 무엇이 사라지는지 직접 읽어 보세요. 분석하기 쉬운 형태를 만들려는 의도와 원래 의미를 보존하는 일은 항상 같지 않을 수 있습니다. 같은 짧은 문장을 다른 방식으로 처리한 뒤 단어의 목록이나 표현이 어떻게 달라지는지 비교할 수 있습니다. 전처리를 정해진 의식처럼 반복하지 않기 위한 연습입니다.
분류 결과가 틀린 사례도 따로 모아 보세요. 제목만으로 주제를 구분하기 어려운지, 여러 의미가 겹쳤는지, 자료의 표기가 달랐는지 생각할 수 있습니다. 정답 비율 하나를 확인하는 것보다 어떤 입력에서 문제가 생기는지 설명하는 데 초점을 두면 좋습니다. 실제 개인의 대화나 비공개 문서를 사용하기보다 공개되었거나 사용이 허용된 자료로 연습해 주세요.
텍스트 분석의 기초와 최신 생성 서비스는 구분합니다
책은 한국어 자료를 다루는 첫 실습에 관심 있는 독자에게 맞는 범위를 제공합니다. 현재의 대규모 언어 모델 서비스가 무엇을 지원하는지 한 번에 파악하려는 목적이라면 다른 자료가 필요합니다. 단어 표현과 분류의 기본을 이해하는 공부와 생성 도구의 최신 기능을 사용하는 공부를 나누면 책을 선택하는 이유도 분명해집니다.
코랩과 라이브러리, 데이터의 접근 방식은 2023년 판본 이후 달라질 수 있습니다. 예제를 실행하기 전에는 환경과 자료를 확인하고 오류가 난 경우 코드의 의미와 설치 조건을 구분해 보세요. 처음에는 전체를 빨리 끝내기보다 작은 한국어 자료의 입력과 처리, 결과를 자신의 말로 설명할 수 있는지를 기준으로 공부하는 편이 좋습니다.
이 책에서 주로 다루는 내용
- 코랩과 파이썬 문자열 처리
- 판다스·넘파이로 텍스트 자료 다루기
- 단어 가방 모형과 TF-IDF의 표현
- 한국어 제목의 전처리와 주제 분류
작가 소개
박조은은 백엔드 개발을 경험하고 데이터사이언스 교육 콘텐츠를 만들어 온 저자입니다. 송영숙은 국어학을 전공하며 전산언어학과 상식 추론, 언어 유형론에 관심을 두고 연구와 집필을 해 왔습니다.